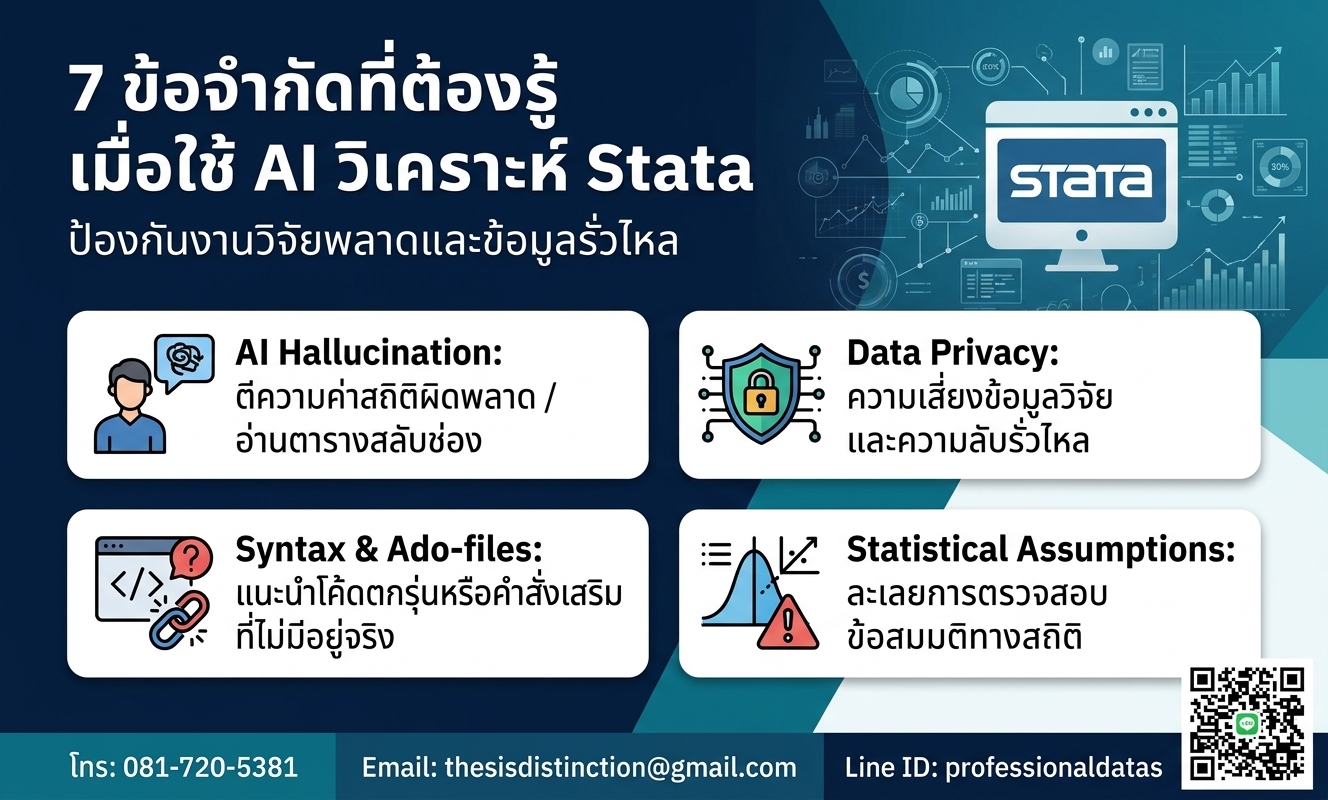
7 ข้อจำกัดที่ต้องรู้ เมื่อใช้ AI วิเคราะห์ Stata ป้องกันงานวิจัยพลาดและข้อมูลรั่วไหล
ข้อควรรู้ การใช้ AI วิเคราะห์ Stata
ในยุคที่เทคโนโลยีปัญญาประดิษฐ์ (Artificial Intelligence) พัฒนาไปอย่างก้าวกระโดด นักวิจัย นักวิชาการ นักศึกษาบัณฑิตศึกษา รวมถึงนักวิเคราะห์ข้อมูลจำนวนมากต่างหันมาใช้เครื่องมือ AI ประเภทโมเดลภาษาขนาดใหญ่ (Large Language Models: LLMs) เช่น ChatGPT, Claude หรือ Gemini มาเป็นผู้ช่วยในการวิเคราะห์ข้อมูลทางสถิติ โดยเฉพาะการใช้งานร่วมกับโปรแกรม Stata ซึ่งเป็นซอฟต์แวร์สถิติมาตรฐานระดับโลกที่ได้รับความนิยมอย่างสูงในสาขาเศรษฐศาสตร์ สังคมศาสตร์ รัฐศาสตร์ และวิทยาศาสตร์สุขภาพ
เหตุผลที่ AI ได้รับความนิยมอย่างรวดเร็วในวงการวิจัย เพราะความสามารถในการช่วยลดระยะเวลาการทำงานที่ซับซ้อน ไม่ว่าจะเป็นการช่วยเขียนชุดคำสั่ง (Do-file) การช่วยค้นหาและแก้ไขข้อผิดพลาดของโค้ด (Debugging) การช่วยแปลงรูปแบบข้อมูล ไปจนถึงการช่วยร่างคำอธิบายผลลัพธ์จากตารางสถิติให้กลายเป็นภาษาเขียนที่สละสลวย อย่างไรก็ตาม การพึ่งพาเทคโนโลยี AI โดยปราศจากความเข้าใจในขอบเขตและข้อจำกัดที่แท้จริง อาจนำไปสู่ความผิดพลาดร้ายแรงที่ทำลายความน่าเชื่อถือของงานวิจัย ละเมิดจริยธรรมการวิจัย หรือทำให้ข้อสรุปทางวิชาการบิดเบือนไปจากความเป็นจริง บทความนี้จะพาคุณไปเจาะลึกถึง 7 ข้อจำกัดสำคัญที่ต้องรู้ก่อนนำ AI มาใช้วิเคราะห์ Stata พร้อมแนวทางการใช้งานอย่างปลอดภัยและมีประสิทธิภาพสูงสุด
7 ข้อจำกัดที่ต้องรู้ เมื่อใช้ AI วิเคราะห์ Stata
1. ปัญหาการสร้างข้อมูลเท็จและการตีความสถิติผิดพลาด (AI Hallucination)
ข้อจำกัดอันดับหนึ่งและเป็นอันตรายที่สุดของ AI ในปัจจุบันคืออาการ “หลอน” หรือ AI Hallucination ซึ่งหมายถึงภาวะที่ปัญญาประดิษฐ์สร้างข้อมูล คำอธิบาย หรือตัวเลขที่ฟังดูน่าเชื่อถือ มีหลักการรองรับ แต่แท้จริงแล้วเป็นข้อมูลที่ผิดพลาดหรือไม่มีอยู่จริง เมื่อผู้วิจัยคัดลอกตารางผลลัพธ์ (Output) จากหน้าต่าง Results ของโปรแกรม Stata ไปวางในช่องแชทเพื่อให้ AI ช่วยแปลผล มักเกิดความผิดพลาดในลักษณะต่อไปนี้:
- การอ่านค่าตัวเลขสลับบรรทัดและสลับคอลัมน์: ตารางผลลัพธ์ของโปรแกรม Stata มีรูปแบบการจัดวางที่เป็นข้อความล้วน (Plain Text) และคั่นด้วยเส้นประ เมื่อตารางมีความซับซ้อนสูง เช่น ตารางการวิเคราะห์สมการถดถอยพหุคูณ (Multiple Regression) ตารางข้อมูลพาเนล (Panel Data) หรือตารางการวิเคราะห์ความแปรปรวน AI มักจะอ่านตำแหน่งตัวเลขผิดพลาด เช่น นำค่าความคลาดเคลื่อนมาตรฐาน (Standard Error) ไปรายงานว่าเป็นค่าสัมประสิทธิ์ (Coefficient) หรือสลับค่า t-statistic กับค่า p-value ทำให้ตัวเลขที่ปรากฏในเนื้อหาบทความขัดแย้งกับตารางผลลัพธ์อย่างสิ้นเชิง
- การตีความนัยสำคัญทางสถิติและทิศทางความสัมพันธ์ผิดเพี้ยน: ในหลายกรณี AI อาจสรุปว่าตัวแปรอิสระมีอิทธิพลต่อตัวแปรตามอย่างมีนัยสำคัญทางสถิติ ทั้งที่ค่า p-value ในตารางสูงกว่าเกณฑ์มาตรฐานที่กำหนดไว้ (เช่น มากกว่า 0.05) นอกจากนี้ AI ยังอาจตีความเครื่องหมายบวกและลบผิดทิศทาง โดยเฉพาะเมื่อตัวแปรถูกสร้างขึ้นจากการแปลงค่า เช่น ค่าลอการิทึม (Logarithm) หรือตัวแปรหุ่น (Dummy Variables) ที่มีการกำหนดกลุ่มอ้างอิง (Reference Group) ซึ่งต้องอาศัยความเข้าใจเชิงลึกในการแปลความหมาย
- การแต่งเติมค่าสถิติที่ไม่มีอยู่จริง: หากผู้วิจัยคัดลอกผลลัพธ์จาก Stata มาวางไม่ครบถ้วน เช่น ตัดส่วนหัวของตารางที่มีค่า R-squared หรือค่า F-statistic ออกไป AI อาจใช้การคาดเดาจากบริบทของข้อความและสร้างตัวเลขสถิติเหล่านั้นขึ้นมาเองโดยไม่แจ้งเตือนผู้ใช้งาน
2. ความเสี่ยงด้านความปลอดภัยและความลับของข้อมูล (Data Privacy & Research Ethics)
งานวิจัยเชิงปริมาณจำนวนมากต้องทำงานกับชุดข้อมูลที่มีความละเอียดอ่อนสูงและมีข้อผูกมัดทางกฎหมายหรือจริยธรรม เช่น ข้อมูลเวชระเบียนผู้ป่วยจากโรงพยาบาล ข้อมูลประวัติอาชญากรรม ข้อมูลทางการเงินส่วนบุคคล ข้อมูลความลับทางธุรกิจ หรือชุดข้อมูลสำรวจระดับประเทศที่นักวิจัยต้องลงนามในข้อตกลงรักษาความลับก่อนขอรับข้อมูลมาวิเคราะห์ การนำไฟล์ชุดข้อมูลนามสกุล
.dta หรือแม้แต่การคัดลอกข้อมูลบางส่วนไปอัปโหลดลงในแพลตฟอร์ม AI สาธารณะ มีความเสี่ยงร้ายแรงดังนี้:- การนำข้อมูลไปใช้ฝึกฝนโมเดลในอนาคต: ผู้ให้บริการ AI สาธารณะส่วนใหญ่ (โดยเฉพาะบัญชีใช้งานฟรีหรือบัญชีบุคคลทั่วไป) มักมีเงื่อนไขการให้บริการที่อนุญาตให้ระบบนำข้อความและไฟล์ที่ผู้ใช้งานป้อนเข้าไปใช้ในการพัฒนาและฝึกฝนโมเดลต่อไป ซึ่งหมายความว่าข้อมูลดิบหรือข้อค้นพบสำคัญจากงานวิจัยที่ยังไม่ผ่านการตีพิมพ์ของคุณ อาจถูกจัดเก็บไว้ในฐานข้อมูลและถูกเรียกแสดงผลให้ผู้ใช้งานคนอื่นเห็นในอนาคต
- การละเมิดหลักจริยธรรมการวิจัยในมนุษย์ (IRB): คณะกรรมการจริยธรรมการวิจัยในมนุษย์มีข้อกำหนดที่เข้มงวดเรื่องการเก็บรักษาความลับของอาสาสมัคร หากชุดข้อมูลของคุณมีรหัสประจำตัวประชาชน ชื่อ-นามสกุล เบอร์โทรศัพท์ หรือข้อมูลทางภูมิศาสตร์ที่สามารถระบุตัวตนของกลุ่มตัวอย่างได้ การอัปโหลดไฟล์ขึ้นไปยังเซิร์ฟเวอร์ของบุคคลที่สามโดยไม่ได้รับความยินยอม ถือเป็นการละเมิดจริยธรรมการวิจัยอย่างร้ายแรงและอาจส่งผลให้ผลงานวิจัยถูกเพิกถอน
3. ข้อจำกัดด้านไวยากรณ์และแพ็กเกจเสริมเฉพาะทาง (Syntax & Community Ado-files)
โปรแกรม Stata เป็นซอฟต์แวร์ที่มีการพัฒนาและอัปเดตเวอร์ชันใหม่อย่างต่อเนื่อง (เช่น Stata 17, Stata 18) อีกทั้งยังมีจุดแข็งสำคัญคือแพ็กเกจคำสั่งเสริมที่พัฒนาโดยนักเศรษฐมิติและนักสถิติทั่วโลก ซึ่งเรียกว่า Community-contributed commands หรือ Ado-files ที่ติดตั้งผ่านคำสั่ง
ssc install จุดแข็งนี้เองที่กลายเป็นจุดอ่อนของ AI เมื่อต้องเขียนโค้ด:- การแนะนำคำสั่งที่ล้าสมัยหรือไม่ตรงเวอร์ชัน: ฐานข้อมูลที่ใช้ฝึกฝน AI ประกอบด้วยโค้ดและบทความบนอินเทอร์เน็ตที่สะสมมานานหลายสิบปี ทำให้ AI มักแนะนำคำสั่งเก่าที่ถูกยกเลิกไปแล้วใน Stata เวอร์ชันปัจจุบัน หรือใช้ไวยากรณ์ (Syntax) แบบเก่าที่ทำให้โปรแกรมทำงานผิดพลาด
- การสร้างชื่อคำสั่งและตัวเลือก (Options) ขึ้นมาเอง: เมื่อต้องวิเคราะห์สถิติขั้นสูง เช่น แบบจำลอง Difference-in-Differences (DID) แบบหลายช่วงเวลา การวิเคราะห์สมการโครงสร้าง (SEM) หรือสถิติเชิงพื้นที่ AI มักจะจำชื่อแพ็กเกจเสริมสับสน และมักแต่งชื่อคำสั่งย่อยหรือตัวเลือกหลังเครื่องหมายจุลภาค (Comma) ขึ้นมาเอง เมื่อผู้วิจัยคัดลอกโค้ดไปรันในหน้าต่าง Do-file Editor ของ Stata ก็จะพบข้อความแจ้งเตือนข้อผิดพลาด (Error Message) สีแดง เช่น
command ... is unrecognizedหรือoption ... not allowedอยู่เสมอ
4. การละเลยการตรวจสอบข้อสมมติทางสถิติ (Statistical Assumptions)
หัวใจสำคัญของการวิเคราะห์ข้อมูลทางสถิติไม่ใช่เพียงการพิมพ์คำสั่งให้โปรแกรมคำนวณตัวเลขออกมาได้สำเร็จ แต่คือการพิสูจน์ว่าชุดข้อมูลและแบบจำลองที่เลือกใช้นั้นผ่านเงื่อนไขหรือข้อสมมติเบื้องต้นทางสถิติ (Statistical Assumptions) อย่างครบถ้วน เพื่อไม่ให้ค่าประมาณการเกิดความลำเอียง (Bias) หรือขาดประสิทธิภาพ (Inefficiency)
AI มีธรรมชาติในการตอบสนองตามคำสั่งของผู้ใช้งานแบบตรงไปตรงมา หากผู้วิจัยสั่งว่า “ช่วยเขียนโค้ดรันสมการถดถอยเพื่อหาความสัมพันธ์ระหว่างรายได้และการศึกษา” AI ก็จะเขียนคำสั่ง
regress income education ให้ทันที โดยไม่เตือนให้ผู้วิจัยตรวจสอบปัญหาความแปรปรวนไม่คงที่ (Heteroskedasticity) ปัญหาความสัมพันธ์กันเองของตัวแปรอิสระ (Multicollinearity) การแจกแจงแบบปกติของค่าความคลาดเคลื่อน (Normality of Residuals) หรือการตรวจหาค่าผิดปกติ (Outliers) หากผู้วิจัยมือใหม่นำผลลัพธ์จากคำสั่งพื้นฐานไปใช้งานทันทีโดยไม่ผ่านกระบวนการวินิจฉัยแบบจำลอง (Model Diagnostics) งานวิจัยชิ้นนั้นจะขาดความเที่ยงตรงทางสถิติอย่างรุนแรง5. การขาดบริบทเชิงทฤษฎีและการออกแบบงานวิจัย (Lack of Research Context)
โมเดลปัญญาประดิษฐ์ทำงานบนพื้นฐานของการคำนวณความน่าจะเป็นของชุดคำ ไม่ได้มีความเข้าใจอย่างลึกซึ้งเกี่ยวกับกรอบแนวคิด ทฤษฎีทางวิชาการ บริบททางวัฒนธรรม หรือวัตถุประสงค์เฉพาะของงานวิจัยแต่ละชิ้น ซึ่งส่งผลกระทบต่อคุณภาพของงานวิจัยในสองมิติหลัก:
- การเลือกแบบจำลองไม่สอดคล้องกับโครงสร้างข้อมูล: หากผู้วิจัยไม่ได้อธิบายที่มาของข้อมูลและรูปแบบการสุ่มตัวอย่างอย่างละเอียด AI มักจะแนะนำให้ใช้แบบจำลองพื้นฐานทั่วไป เช่น Pooled OLS ทั้งที่ในความเป็นจริง ชุดข้อมูลนั้นอาจเป็นข้อมูลระยะยาว (Longitudinal Data) ที่ต้องควบคุมอิทธิพลคงที่รายบุคคล (Fixed Effects) หรือข้อมูลที่มีปัญหาความลำเอียงจากการคัดเลือกกลุ่มตัวอย่าง (Sample Selection Bias) ที่ต้องใช้แบบจำลอง Heckman Selection หรือตัวแปรหุ่นเครื่องมือ (Instrumental Variables: IV)
- การเขียนอภิปรายผลที่ผิวเผินและขาดมิติทางวิชาการ: เมื่อผู้วิจัยสั่งให้ AI ช่วยเขียนส่วนอภิปรายผล (Discussion) เนื้อหาที่ได้มักเป็นเพียงการนำตัวเลขจากตารางมาเขียนเรียบเรียงใหม่ในรูปแบบความเรียง แต่ไม่สามารถอธิบายกลไกเชิงสาเหตุ (Causal Mechanism) หรือเชื่อมโยงข้อค้นพบเข้ากับทฤษฎีหลักและงานวิจัยในอดีตได้อย่างเฉียบคม ทำให้งานเขียนขาดน้ำหนักทางวิชาการ
6. ข้อจำกัดในการจัดการข้อมูลขนาดใหญ่และซับซ้อน (Data Management Limits)
ในกระบวนการทำวิจัยเชิงปริมาณ ขั้นตอนที่ใช้เวลามากที่สุดและเกิดความผิดพลาดได้ง่ายที่สุดคือขั้นตอนการเตรียมและทำความสะอาดข้อมูล (Data Cleaning & Management) เช่น การตรวจสอบค่าสูญหาย (Missing Values) การรวมชุดข้อมูลหลายไฟล์เข้าด้วยกัน (Merging & Appending) การจัดกลุ่มตัวแปรใหม่ และการแปลงโครงสร้างข้อมูลระหว่างรูปแบบ Wide และ Long ด้วยคำสั่ง
reshapeแม้ AI จะสามารถเขียนโค้ดจัดการข้อมูลพื้นฐานได้ดี แต่เมื่อต้องเผชิญกับเงื่อนไขทางตรรกะที่ซับซ้อน AI มักจะเขียนเงื่อนไขผิดพลาด ตัวอย่างเช่น ในโปรแกรม Stata ค่าสูญหายแบบตัวเลข (
.) จะถูกโปรแกรมมองว่ามีค่ามากกว่าตัวเลขบวกทั้งหมด (infinity) หาก AI เขียนคำสั่งสร้างตัวแปรใหม่โดยใช้เครื่องหมายมากกว่า เช่น generate high_income = 1 if income > 50000 โดยลืมใส่เงื่อนไขตัดค่าสูญหาย (& !missing(income)) โปรแกรม Stata จะจัดให้กลุ่มตัวอย่างที่ไม่มีข้อมูลรายได้กลายเป็นกลุ่มที่มีรายได้สูงทั้งหมด ซึ่งความผิดพลาดเล็กน้อยในระดับโค้ดเช่นนี้ สามารถทำให้ผลลัพธ์การวิจัยทั้งหมดพังทลายลงได้โดยที่ผู้วิจัยไม่ทันสังเกตเห็น7. ความเสี่ยงต่อการสูญเสียทักษะการคิดเชิงวิพากษ์ (Loss of Analytical Skills)
ข้อจำกัดข้อสุดท้ายไม่ได้เกิดจากตัวซอฟต์แวร์หรืออัลกอริทึมของ AI แต่เกิดขึ้นกับตัวผู้วิจัยเอง การพึ่งพา AI ในการเขียน Do-file แก้ไขโค้ด และแปลผลลัพธ์ตั้งแต่ต้นจนจบอย่างต่อเนื่อง ทำให้นักวิจัยและนักศึกษาขาดโอกาสในการฝึกฝนทักษะการแก้ปัญหา การอ่านคู่มือทางสถิติ และการทำความเข้าใจธรรมชาติของข้อมูลด้วยตนเอง
เมื่อต้องเผชิญกับสถานการณ์จริง เช่น การสอบป้องกันวิทยานิพนธ์ การตอบข้อซักถามของกรรมการผู้ทรงคุณวุฒิ (Peer Reviewers) ในวารสารวิชาการ หรือการแก้ไขปัญหาเฉพาะหน้าเมื่อข้อมูลมีข้อจำกัด ผู้วิจัยที่พึ่งพา AI มากเกินไปจะไม่สามารถอธิบายเหตุผลเบื้องหลังการเลือกใช้สถิติ วิธีจัดการตัวแปร หรือข้อจำกัดของแบบจำลองได้อย่างมั่นใจ ซึ่งส่งผลเสียต่อความน่าเชื่อถือในฐานะนักวิจัยในระยะยาว
แนวทางปฏิบัติที่ดีในการใช้ AI ร่วมกับ Stata อย่างมืออาชีพ
เพื่อให้การใช้ AI เกิดประโยชน์สูงสุด ช่วยประหยัดเวลา และปลอดภัยจากข้อจำกัดทั้ง 7 ข้อข้างต้น ผู้วิจัยควรยึดหลักปฏิบัติที่เป็นมาตรฐานดังต่อไปนี้:
- วางบทบาท AI เป็นเพียงผู้ช่วย ไม่ใช่ผู้ตัดสินใจหลัก: ใช้ AI สำหรับการร่างโครงสร้าง Do-file เบื้องต้น ช่วยจัดรูปแบบตาราง หรือช่วยตรวจสอบไวยากรณ์ของโค้ด แต่ผู้วิจัยต้องเป็นผู้ตรวจสอบตรรกะทางสถิติและรันทดสอบผลลัพธ์ทุกบรรทัดด้วยตนเองเสมอ
- ปกป้องความลับของข้อมูลอย่างเคร่งครัด: ห้ามอัปโหลดไฟล์ข้อมูลดิบ (
.dta,.csv,.xlsx) ที่มีข้อมูลส่วนบุคคลหรือข้อมูลงานวิจัยที่ยังไม่เผยแพร่ลงใน AI สาธารณะโดยเด็ดขาด หากต้องการให้ AI ช่วยเขียนโค้ดจัดการข้อมูล ให้ส่งเฉพาะชื่อตัวแปร ประเภทของตัวแปร (String หรือ Numeric) หรือสร้างชุดข้อมูลจำลอง (Mock Data) ขึ้นมาเป็นตัวอย่างแทน - ตรวจสอบความถูกต้องกับคู่มือของ Stata เสมอ: ทุกครั้งที่ AI แนะนำคำสั่งใหม่หรือตัวเลือกที่ไม่คุ้นเคย ให้พิมพ์คำสั่ง
help ตามด้วยชื่อคำสั่งในหน้าต่าง Command ของโปรแกรม Stata เพื่ออ่านคำอธิบายอย่างเป็นทางการและตรวจสอบว่าคำสั่งนั้นมีอยู่จริงและทำงานตรงตามวัตถุประสงค์หรือไม่ - แบ่งงานเป็นส่วนย่อยและระบุบริบทให้ชัดเจน: แทนที่จะสั่งให้ AI วิเคราะห์ข้อมูลทั้งหมดในครั้งเดียว ควรแบ่งคำสั่งออกเป็นขั้นตอนย่อยๆ เช่น ขั้นตอนการทำความสะอาดข้อมูล ขั้นตอนการวิเคราะห์สถิติเชิงพรรณนา และขั้นตอนการสร้างแบบจำลอง พร้อมทั้งอธิบายลักษณะของข้อมูลและสมมติฐานการวิจัยให้ AI ทราบอย่างละเอียด
บทสรุป
ปัญญาประดิษฐ์เป็นเครื่องมือที่ทรงพลังและเข้ามาเปลี่ยนโฉมการทำงานร่วมกับโปรแกรม Stata ให้มีความสะดวกและรวดเร็วยิ่งขึ้น แต่เทคโนโลยีนี้ก็ยังมีข้อจำกัดที่ชัดเจน ทั้งในเรื่องความแม่นยำในการอ่านค่าสถิติ ปัญหาการสร้างข้อมูลเท็จ ความเสี่ยงด้านความปลอดภัยของข้อมูล รวมถึงการขาดความเข้าใจในบริบททางทฤษฎี
การตระหนักรู้ถึงข้อจำกัดเหล่านี้จะช่วยให้ผู้วิจัยสามารถวางขอบเขตการใช้งานได้อย่างเหมาะสม เมื่อผสานความรวดเร็วของ AI เข้ากับความรู้ทางสถิติที่แม่นยำและการคิดเชิงวิพากษ์ของมนุษย์ งานวิจัยของคุณก็จะมีความสมบูรณ์ น่าเชื่อถือ และพร้อมรับการตรวจสอบในระดับสากลได้อย่างภาคภูมิใจ